Бекъп в Proxmox: правилото 3-2-1 и тестът, който спасява
Как подреждам бекъпи в Proxmox VE: vzdump режимите, retention, Proxmox Backup Server с дедупликация и правилото 3-2-1.
Предварителни изисквания
- Инсталиран Proxmox VE с поне едно хранилище за бекъпи
- Базови познания по Proxmox хранилища (storage)
Една вечер, преди години, сървърът ми с всичко важно изгасна и не се вдигна. Имах бекъп — тоест, имах файл с разширение .vma.zst, за който уверено твърдях, че е бекъп. Когато най-сетне се наложи да възстановя от него, файлът беше непълен: беше се писал на диск, който отдавна сигнализираше проблеми, а аз не бях погледнал логовете. Данните ги спасих (и за това какво ми помогна, ще стане дума по-долу), но урока остана: бекъпът не е това, което копираш, а това, което реално възстановяваш. Тази статия е за това как подреждам бекъпи в Proxmox, за да не разчитам на късмет.
vzdump и трите режима: snapshot, suspend, stop
В Proxmox всичко започва с вградения инструмент vzdump — това е механизмът, който стои зад бутона Backup now и зад планираните задачи в Datacenter → Backup. Той пакетира VM или контейнер в компресиран архив. Изборът, който наистина има значение, е режимът:
| Режим | Как работи | Кога го ползвам |
|---|---|---|
snapshot | Замразява състоянието мигновено и пише архива на заден план; машината работи без осезаем пауза | По подразбиране за всичко, когато хранилището поддържа снимки (ZFS, LVM-thin, Ceph, qcow2) |
suspend | Спира машината за времето на копиране, после я събужда | Стари сървъри без поддръжка на snapshot, където кратка пауза не боли |
stop | Пълно изключване за периода на бекъпа | Състоянието е критично важно (бази данни с агресивен кеш) и downtime-ът е приемлив |
Ако ви се струва, че stop е „най-сигурният, значи най-правилният” — съгласен съм с логиката, но на практика snapshot при ZFS или qcow2 е напълно консистентен за почти всяка услуга, а за базите данни трябва да комбинирате с вътрешни механизми на самата БД. Не ме разбирайте погрешно: режимът е половината работа, другата половина е какво прави машината, докато я архивирате.
Къде отиват архивите и най-вече — колко ги има
Един от най-честите досадии с Proxmox бекъпи е, че дискът с архивите един ден е пълен. Причината е проста: без политика за задържане (retention) всеки ден добавя нов архив и никой не изтрива старите. Задавате това на ниво бекъп задача — секция Retention:
keep-daily 7— последните седем дневни;keep-weekly 4— четири седмични;keep-monthly 3— три месечни, „за всеки случай”.
Общият принцип: по-новите архиви са много, по-старите — все по-малко и по-редки. Така изрязвате отневящия се проблем, без да губите история. И проверявайте размерите! Ако дневният архив рязко е по-голям от обикновено, нещо в машината пише данни, които не е трябвало.
Кога да върви бекъпът и как да не изяде машината
Планирането на бекъп задача е половината рутинно, половината стратегическо. Рутинното: нощни часове, когато машините работят най-малко — в домашна лаборатория това е около 03:00, в офис среда може да е събота сутринта. Стратегическото е друго:
- Разнесете задачите. Ако дванайсет машини тръгнат в 03:00, в 03:05 ще откриете, че дискът е един и огънят е общ. Няколко задачи с по няколко машини всяка е по-добре от една гигантска.
- Bandwidth limit. В задачата може да сложите ограничение на скоростта (
bwlimit) — полезно, когато бекъпът върви по мрежа, по която други хора работят денонощно. - Обърнете внимание на последователността. Ако ползвате ZFS репликация между възли, оставете бекъпът след репликацията, за да стигнат и двете неща до края си без да се гризат за диска.
И нещо, за което си напомням на глас: включете нотификациите и ги четете. Proxmox праща мейл след всяка задача. Бекъп, който мълчи три седмици, не е бекъп, а предстояща изненада.
Proxmox Backup Server — кога си струва
За две-три машини класическият vzdump върши работа. Но щом данните надхвърлят няколко сотни гигабайта или възлите станат няколко, препоръчвам отделен Proxmox Backup Server (PBS). Това е безплатен, самостоятелен сървър, който приема бекъпи от всички възли и прави три неща, заради които аз никога не се връщам назад:
- Дедупликация. PBS пази общите блокове веднъж. След първия пълен бекъп следващите са инкрементални — пренася се само промененото. Стига да видите, че седмичен бекъп на 200-гигабайтова VM заема само промяната, вече не гледате назад.
- Проверка на целостта. Периодично пуснати verification задачи — PBS сам си преглежда записаните данни и ви казва дали всичко е ок. Зная, че звучи банално, но това е точно нещото, което ми липсваше тогава с непълния архив.
- Редовност. Инкременталност + дедупликация = бекъпите са бързи, а бързите бекъпи се правят често — и често правените бекъпи означават малки загуби при авария.
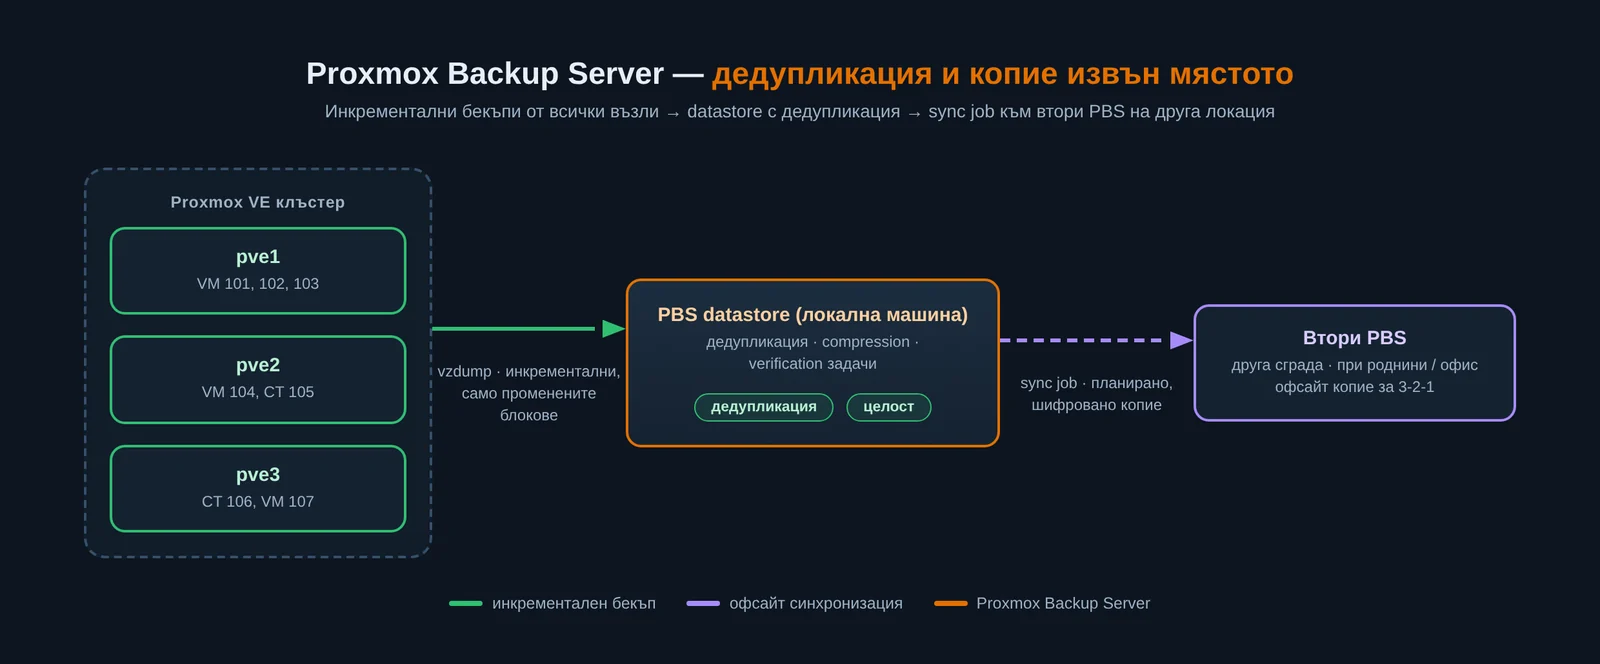
Възлите пращат инкрементални бекъпи в datastore-а на PBS, а sync job ги праща на втори PBS извън сградата.
PBS го въртя дори на малка мини-машина — казано просто, не ви е нужен флот от сървъри. Дедупликацията прави дори скромен диск да съдържа месеци история.
Една бележка, която рядко я пише някой: ако третото копие отива при роднини или в облак, включете шифроване на sync job-а. Ключът пазете на две места — загубен ключ върху шифрован datastore е еквивалент на изгорен сейф. Всяка минута, прекарана в размисъл къде да стои този ключ, има по-висока възвръщаемост от всеки нов харддиск.
Правилото 3-2-1, приложено за реални хора
Класическото правило е: 3 копия на данните, на 2 различни носителя, с 1 извън мястото (offsite). В Proxmox контекст то се превежда ужасно практично:
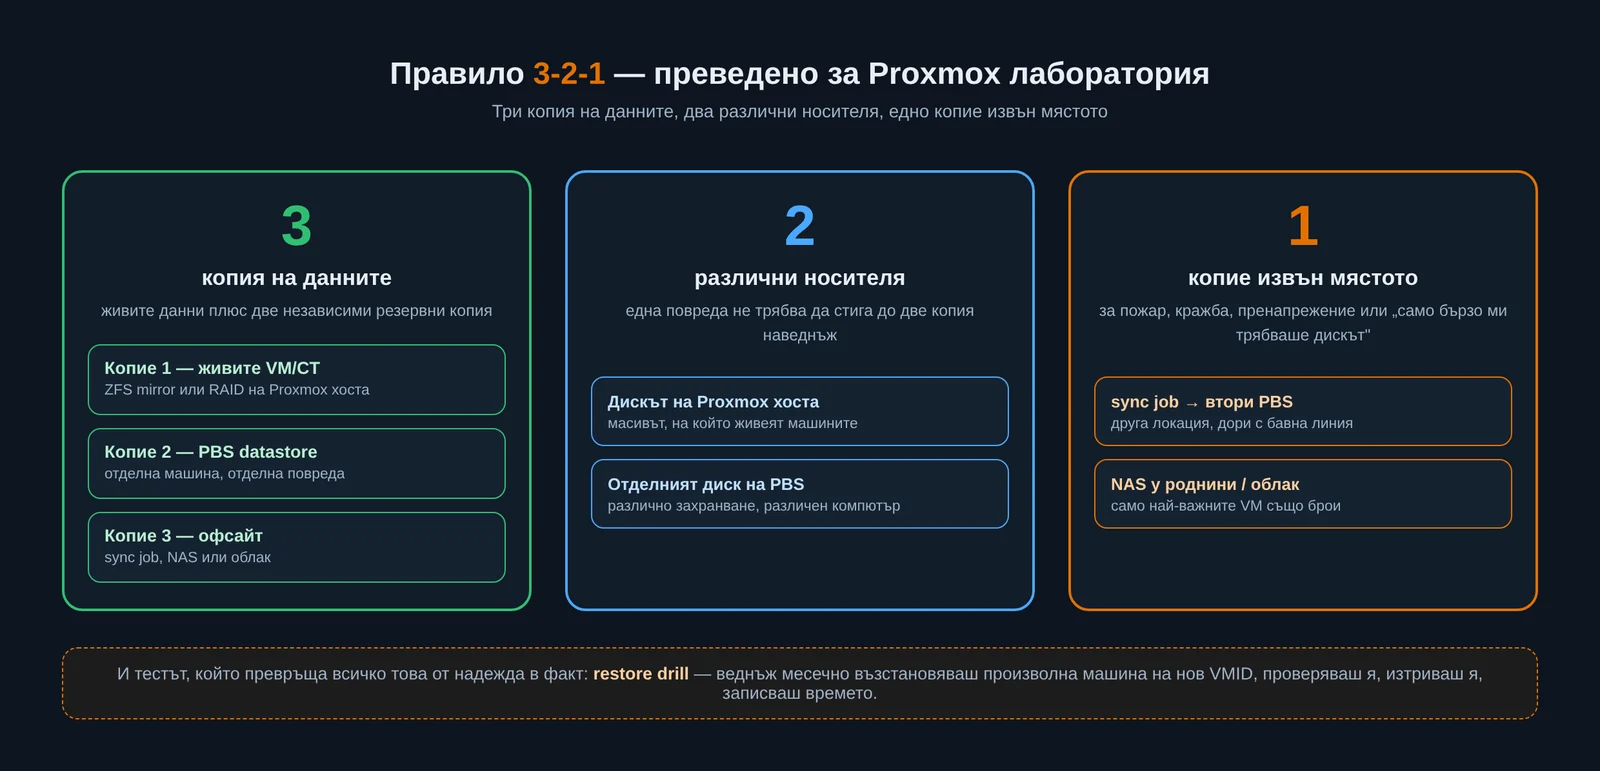
- Копие 1 — живите VM-и и контейнери на Proxmox масива (ZFS mirror или RAID);
- Копие 2 — бекъпи на PBS datastore на отделна машина (различен носител, различно захранване, различен сценарий на повреда);
- Копие 3 — синхронизирани архиви другаде: sync job към втори PBS у роднини/офис, NAS в друга сграда, облак.
Ако третото копие ви се струва свръхпредизвикателство, започнете с най-простото: PBS sync job към друг PBS (дори на съседна локация с по-бавна линия) или само най-важните VM на NAS по стария начин с vzdump. Не е перфектно, но е светлинна година преди „всичко е в един масив”.
Възстановяване на един-единствен файл
Класическа ситуация: човекът не иска цялата машина обратно — иска един конфигурационен файл от снощи. За един ред не възстановявате цялата машина. Имате три пътя, според типа бекъп:
- PBS file restore. Когато архивът е в PBS, върху него в уеб интерфейса има бутон File Restore — виждате файловата система отвътре и теглите това, което ви трябва, без да вдигате VM. Само по себе си това е причина PBS да си заслужава и за две машини.
- vzdump на контейнер (LXC). Архивът е tar — изваждате си файла директно:
tar -xvf vzdump-lxc-103-...tar.zst etc/nginx/nginx.conf. - vzdump на VM. Архивът е образ на диск и вътре се влиза с
qemu-nbd:
modprobe nbd max_part=8
qemu-nbd --connect=/dev/nbd0 vzdump-qemu-101-2026_11_15-10_00_00.vma.zst
mount /dev/nbd0p1 /mnt/rescue
# …копирате си файла…
umount /mnt/rescue
qemu-nbd --disconnect /dev/nbd0
Първите месеци проверявах тези пътища ръчно, после го написах на стикер на монитора: ако единственият ви път към „малка част от данните” минава през възстановяване на цяла машина, сте настроили бекъпите удобно за вас, а не за хората, които ги ползват.
Restore drill — тестът, който никой не прави и всички трябва
Ето последната ми теория на практика: бекъп, който не е бил възстановяван, не е бекъп — той е суеверие. Затова веднъж месечно правя restore drill:
- Избирам произволен VM или контейнер от бекъпите.
- Възстановявам го с нов ID на свободно хранилище (в GUI: restore → нов VMID; или от CLI:
qmrestore vzdump-qemu-101-2026_11_15-10_00_00.vma.zst 999 --storage local-lvmза VM иpct restore 999 /mnt/pbs/vzdump-lxc-103-....tar.zst --storage local-lvmза контейнер). - Проверявам: услугата вътре тръгва ли, данните актуални ли са, конфигурацията непокътната ли.
- Изтривам тестовата машина и записвам колко време отне.
Restore drill: възстановяваш на нов ID, проверяваш, изтриваш. Петнайсет минути спокойствие за целия месец.
Този ритуал ме е спасявал повече от веднъж: открива забравени бекъп задачи, празни retention списъци, машини, които никой не си спомня за какво служат. И най-важното — когато настъпи истинска авария, вече знаете, че процедурата работи и колко време отнема. Паниката при авария е обратна пропорционална на броя на тренировките.
Малка частота от практиката: за малка лаборатория един пълен drill на месец е напълно достатъчно; за по-сериозна среда — по-често и на слоеве (един файл, една машина, цяла услуга). И записвайте две числа: колко време отне възстановяването и колко данни изостанаха от последния успешен бекъп. Първото число е вашето RTO (колко бързо връщате услугата), второто — RPO (колко данни сте готови да изгубите). Да можеш да кажеш на глас „връщане на услугата — четирийсет минути, загуба на данни — до шест часа” променя напълно начина, по който разговорите вървят по време на авария.
В заключение
Не съм желал да изляза с революционни идеи в тази статия — идеите отдавна са известни. Редовни бекъпи в понятен режим, ясна retention политика, PBS, когато данните пораснат, копие извън мястото и периодичен тест на възстановяването. Това е всичко. Но именно това „всичко”, изпълнено последователно, е разликата между администратор, който мисли за бекъпи, и администратор, който моли за тях. Дискът не пита кога ви е удобно да умре — затова добре подредените бекъпи са единственият път да не го разберете това по най-лошия възможен начин.